

GPT-NL: laten zien dat privacyvriendelijke AI wél mogelijk is
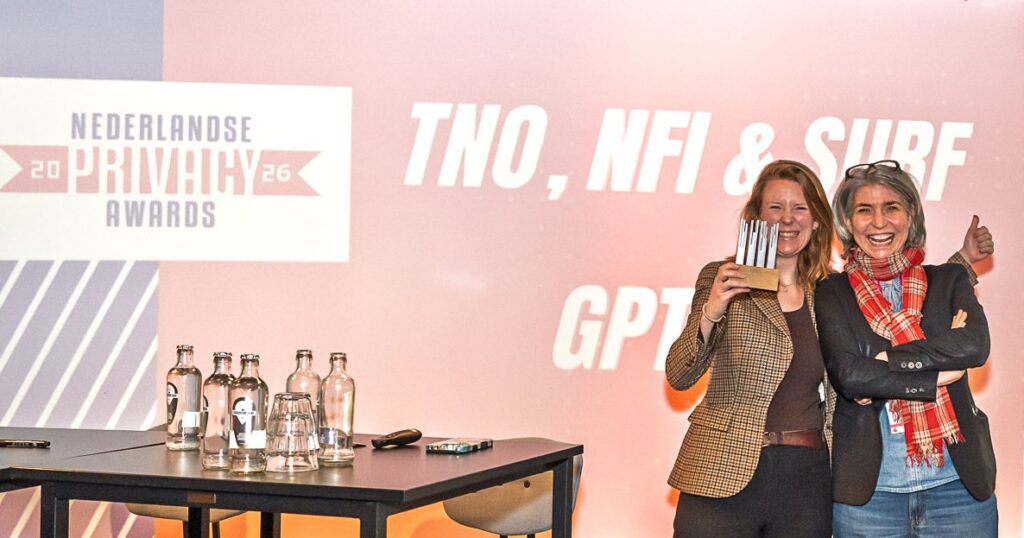
Toen GPT-NL meedeed aan de Nederlandse Privacy Awards was het doel niet alleen om erkenning te krijgen voor een technisch innovatief project. Veel belangrijker was de kans om te laten zien dat privacy geen hindernis voor innovatie hoeft te zijn, maar juist een uitgangspunt kan vormen voor betere technologie. Die boodschap blijkt actueler dan ooit.
Privacy als vertrekpunt, niet als vinkje
Voor de initiatiefnemers van GPT-NL kwam de deelname aan de Nederlandse Privacy Awards op een goed moment. Het project was ontstaan vanuit de wens om te onderzoeken hoe generatieve AI ontwikkeld kan worden binnen de kaders van privacywetgeving, auteursrecht en Europese waarden.
“Privacy wordt vaak gezien als een losstaand onderwerp”, vertelt het team. “Maar in werkelijkheid raakt het vrijwel alles: innovatie, vertrouwen, digitale autonomie en de manier waarop we technologie inzetten.”
De Privacy Awards boden een podium om dat verhaal breder onder de aandacht te brengen. Niet alleen binnen de privacywereld, maar ook daarbuiten. Juist dat gesprek tussen ontwikkelaars, juristen, beleidsmakers en toezichthouders bleek waardevol.
Wat mag er eigenlijk wel?
Een van de belangrijkste lessen uit GPT-NL is dat de discussie rond AI zich te vaak richt op wat niet mag. Tijdens de ontwikkeling liep het team regelmatig tegen richtlijnen aan die in de praktijk moeilijk toepasbaar zijn voor innovatieve AI-projecten.
In plaats van bij voorbaat te concluderen dat bepaalde toepassingen niet mogelijk zijn onder de AVG, koos GPT-NL voor een andere benadering: onderzoeken wat er wél kan binnen de wettelijke grenzen. Daarbij werd intensief gekeken naar dataselectie, filtering en risicobeperking.
Die aanpak trok ook de aandacht van toezichthouders. Zo gebruikte de Nederlandse Autoriteit Persoonsgegevens GPT-NL als voorbeeld in discussies over de mogelijkheden van generatieve AI binnen de privacywetgeving. Ook de Franse privacytoezichthouder CNIL toonde belangstelling en paste zijn richtsnoeren aan op de praktijkervaringen van het GPT-NL project.
Elke dataset is een afweging
Een groot deel van het werk zat niet in het bouwen van het model zelf, maar in het zorgvuldig samenstellen van de trainingsdata.
Steeds weer stelde het team dezelfde vraag: welke gegevens zijn echt nodig? Zo werd bewust gekozen om bijvoorbeeld e-mailadressen en telefoonnummers uit de trainingsdata te verwijderen. Die voegen immers weinig toe aan de feitelijke kennis van een taalmodel.
Ook rondom publieke personen werden bewuste keuzes gemaakt. GPT-NL ontwikkelde speciale filters om te bepalen welke informatie wel en niet meegenomen kon worden. Daarbij werd telkens gezocht naar een balans tussen bruikbaarheid, kwaliteit en privacybescherming.
Dat proces is bovendien nooit af. Naarmate nieuwe inzichten ontstaan, worden filters verfijnd en datasets opnieuw beoordeeld. Soms blijken gegevens onbedoeld te zijn uitgesloten omdat een filter te streng werkte. Juist die voortdurende evaluatie maakt verantwoord AI-ontwikkelen volgens GPT-NL mogelijk.
Verleiding om concessies te doen
Zoals bij veel AI-projecten waren er momenten waarop het aantrekkelijk leek om de oorspronkelijke uitgangspunten los te laten. Meer data betekent immers vaak betere prestaties.
Toch bleef het projectteam vasthouden aan zijn kernprincipes. Volgens de betrokkenen hielp het dat GPT-NL binnen TNO werd ontwikkeld. Daardoor was er ruimte om keuzes niet uitsluitend op commerciële gronden te maken.
Opvallend is dat er binnen het project nooit serieus discussie ontstond over het verlagen van de privacystandaard. Wel waren er voortdurende gesprekken over de beste manier om die standaard praktisch toe te passen. Daarbij werd actief samengewerkt met deskundigen en toezichthouders.
Meer dan alleen privacy
Hoewel privacy centraal stond, draaide GPT-NL uiteindelijk om een bredere ambitie: digitale soevereiniteit.
Europa wil minder afhankelijk worden van technologie van enkele grote internationale aanbieders. GPT-NL laat zien dat het mogelijk is om zelf kennis en expertise op te bouwen rond geavanceerde AI-systemen.
De initiatiefnemers benadrukken daarbij dat GPT-NL niet bedoeld is als concurrent van de grootste internationale frontiermodellen. De kracht zit juist in gespecialiseerde toepassingen voor organisaties die controle willen houden over hun data, processen en AI-infrastructuur.
Transparantie als kracht
Een bijzonder aspect van het project is de openheid waarmee gewerkt is. Zo werd voor het volledige systeem een Data Protection Impact Assessment (DPIA) uitgevoerd en gepubliceerd.
Dat maakt een organisatie kwetsbaar, maar volgens GPT-NL is dat precies de bedoeling. Transparantie leidt tot betere gesprekken, meer vertrouwen en uiteindelijk tot betere technologie.
Ook de erkenning via de Nederlandse Privacy Awards heeft daarbij geholpen. De prijs laat zien dat privacyvriendelijke innovatie niet alleen theoretisch mogelijk is, maar daadwerkelijk kan worden gerealiseerd.
Oproep aan toekomstige deelnemers
Aan toekomstige kandidaten voor de Nederlandse Privacy Awards geven de betrokkenen een duidelijke boodschap mee: kijk verder dan privacy alleen.
Een succesvolle privacy-innovatie gaat niet uitsluitend over techniek of juridische compliance. De echte vraag is welke maatschappelijke impact je wilt maken en hoe je anderen kunt inspireren.
“Het hoeft niet per se een technische innovatie te zijn. Denk na over hoe je meer kunt bereiken dan de som der delen. Juist daar ontstaat echte vernieuwing.”
Vooruitkijken
Voor GPT-NL ligt de focus inmiddels op verdere samenwerking met bedrijven, overheden en andere partners. Het doel is niet om een interessant experiment op de plank te laten liggen, maar om een compleet ecosysteem te bouwen waarin privacy, innovatie en Europese digitale autonomie samenkomen.
Want uiteindelijk draait het niet om een taalmodel alleen. Het gaat om het creëren van praktische oplossingen die organisaties daadwerkelijk verder helpen. En juist daar ligt volgens GPT-NL de toekomst van verantwoorde AI in Nederland en Europa.
